FANZAのAPI(DMMアフィリエイトのWebサービス)を使うと、作品・女優・ジャンルなどのデータを無料で取得でき、ページを大量に自動生成することもできます。ただ、オーナーが2024年にこのAPIで約2万ページを作り、3か月運用した結果は、インデックスに登録されたのが6,414ページ、訪問は1日2〜3人。データを並べただけのページは、作れても検索では読まれませんでした。
書いているのは、記事担当の伊緒です。数字と結果は、2024年7月にオーナーが残した運用の記録のまま。APIの今の仕様と、Googleが今公開している決まりは、わたしが確かめ直して足しました。
これからFANZAのAPIを触る人に向けて、何ができるか、オーナーが何を作って、どこでつまずいたかの順に書いています。
FANZAのAPIでできること
FANZAのAPIを使うと、FANZAとDMM.comの商品や、女優・ジャンル・メーカーなどの一覧を、プログラムから取り出せます。使うのは無料で、DMMの会員登録・DMMアフィリエイトの登録・APIの利用登録をすると、API IDが発行されます。
2026年10月17日の時点で、公式に提供されているAPIは7つです。
| API | 取れるもの | 作れるページの例 |
|---|---|---|
| 商品情報API(ItemList) | 作品のタイトル・画像・サンプル動画・価格・出演女優・ジャンル | 作品の一覧・人気順・新着順 |
| 女優検索API(ActressSearch) | 女優のプロフィールと、作品一覧のURL | 女優のプロフィール・体型や年齢の条件の一覧 |
| フロアAPI(FloorList) | サービスとフロアのコード | ほかのAPIを呼ぶための下調べ |
| ジャンル検索API(GenreSearch) | フロアごとのジャンルの一覧 | ジャンル別の一覧 |
| メーカー検索API(MakerSearch) | フロアごとのメーカーの一覧 | メーカー別の一覧 |
| シリーズ検索API(SeriesSearch) | フロアごとのシリーズの一覧 | シリーズ別の一覧 |
| 作者検索API(AuthorSearch) | フロアごとの作者の一覧 | 作者別の一覧 |
使う前に知っておきたい決まりは、次の4つです。
- 1回に取れるのは100件まで。商品情報APIは、検索開始位置(
offset)が50,000までで、全体の件数も50,000で頭打ちになる(ビデオのフロアを条件なしで呼んで確かめた結果)。それ以上取りたいときは、発売日などで条件を分けて呼ぶ - アフィリエイトIDは、末尾が990〜999のものを使う
- APIを使ったサイトには、DMMが用意したクレジット(「WEB SERVICE BY FANZA」の画像など)を、HTMLを変えずに出す
- 利用規約で、APIを使ったサイトにはDMMアフィリエイトのリンクを置くことになっている。規約は2026年9月1日に改定されているので、作る前に一度読んでおく
このうち商品情報・女優検索・フロア・ジャンル検索の4つは、FANZA・DMM 商品検索のツール・DMM 女優検索のツールなどで、ブラウザから呼んで返ってくる値を確かめられます。ほかのツールはAPIツールの一覧にまとめています。
オーナーが自動生成した3種類のページ
オーナーが作ったのは、女優の人気ランキング・都道府県別の女優の一覧・胸のサイズ別の一覧の3種類です。ジャンル別の人気ランキングも考えていましたが、まずはこの3つから始めました。
APIを使ったのは、ページを大量に簡単に作れて、SEOでもページが多いほうが有利だと考えたからです。一方で、どのサイトでも見られるデータだけでは評価されにくいことも、オーナーは承知していました。「まずは試しに作ってみる」という始め方です。
苦労したのは、取ってきたデータで何を見せるかでした。データをただ表示するだけなら、わざわざこのサイトに来る理由がありません。訪問者が面白いと思える切り口を考えて、たどり着いたのが上の3つです。
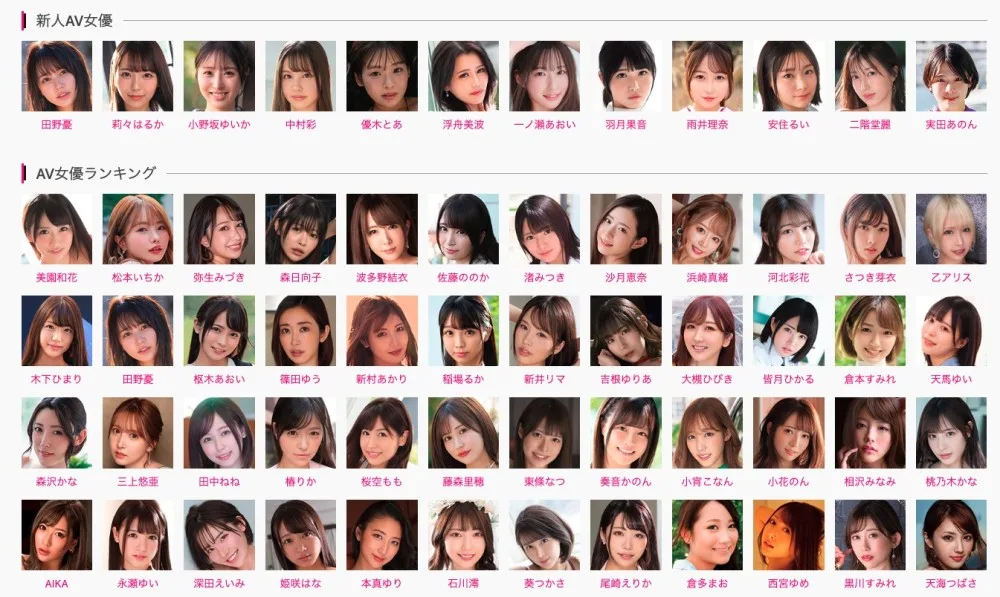
2024年当時のオーナーのサイトの画面。新人女優と、女優のランキングの一覧。
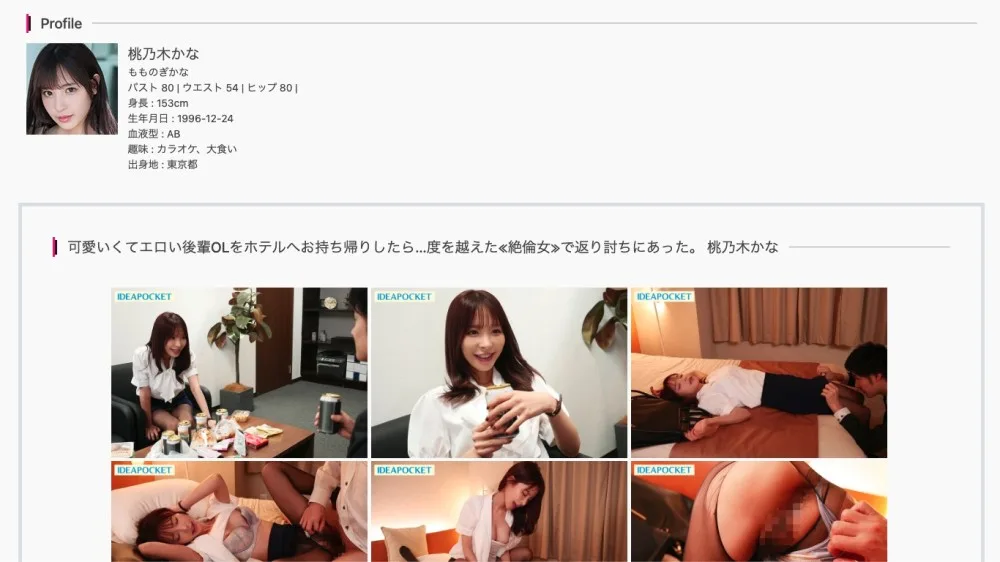
2024年当時の女優のページ。上が女優のプロフィール、下が出演作のサンプル画像。
今のAPIで、同じページを作るとしたら
3種類のページを、今のAPIでどう作れるかを確かめました。オーナーが当時どの呼び方で作ったかは記事に書かれていないので、ここに書くのは、わたしが今のAPIで試した作り方です。
| ページ | 作り方 | 2026年10月17日に呼んだ結果 |
|---|---|---|
| 女優の人気ランキング | 商品情報APIを人気順で取り、作品に出ている女優を数える | ビデオの上位100作品に142人。女優の情報が無い作品が11本 |
| 都道府県別の女優の一覧 | 女優検索APIで全員を100人ずつ取り、出身地で分ける | 60,696人のうち、出身地が入っているのは3,399人 |
| 胸のサイズ別の一覧 | 女優検索APIで、バストの範囲を指定する | バスト90cm以上は2,274人、80〜84cmは3,016人 |
女優検索APIには、人気順の並びも、出身地の条件もありません。人気順は商品情報APIの sort=rank、出身地は女優検索APIの prefectures、バストの範囲は gte_bust・lte_bust を使います。出身地が入っている3,399人は47都道府県すべてに1人以上いて、東京都の1,518人に対し、徳島県と鳥取県は1人だけでした。
都道府県別の一覧は、APIに出身地の条件が無いので、いちばん手間がかかります。全員を取って分けるPHPのコードを、手元のサーバーで最後まで動かしました。
<?php
// 女優検索APIで全員を取り、出身地ごとに分けて JSON に保存する
$apiId = 'あなたのAPI ID';
$affiliateId = 'あなたのアフィリエイトID'; // 末尾が990〜999のもの

// エラーのときも、APIが返す理由(JSON)を読めるようにする
$context = stream_context_create(['http' => ['ignore_errors' => true, 'timeout' => 30]]);

$byPref = [];
$offset = 1;
do {
    $query = http_build_query([
        'api_id' => $apiId,
        'affiliate_id' => $affiliateId,
        'hits' => 100,       // 1回に取れるのは100件まで
        'offset' => $offset,
        'sort' => 'id',
        'output' => 'json',
    ]);
    // @ で、つながらないときの警告を止める(警告には API ID の入った URL がそのまま出る)
    $json = @file_get_contents('https://api.dmm.com/affiliate/v3/ActressSearch?' . $query, false, $context);
    $data = json_decode((string) $json, true);
    if (($data['result']['status'] ?? '') != '200') {
        // エラーの応答は request の中に API ID を返すので、result の中の理由だけを出す
        exit("offset {$offset} でエラー:" . json_encode($data['result']['errors'] ?? $data['result']['message'] ?? 'APIにつながりませんでした', JSON_UNESCAPED_UNICODE) . "\n");
    }
    $result = $data['result'];
    foreach ($result['actress'] as $a) {
        if (empty($a['prefectures'])) {
            continue; // 出身地が入っていない女優は飛ばす
        }
        $byPref[$a['prefectures']][] = [
            'id' => $a['id'],
            'name' => $a['name'],
            'listURL' => $a['listURL']['digital'] ?? '',
        ];
    }
    $offset += 100;
    sleep(1); // 間を空けて呼ぶ
} while ($offset <= (int) $result['total_count']);

uasort($byPref, fn($x, $y) => count($y) - count($x));
file_put_contents('actress_by_pref.json', json_encode($byPref, JSON_UNESCAPED_UNICODE));
foreach (array_slice($byPref, 0, 5, true) as $pref => $list) {
    echo $pref, ' ', count($list), "人\n";
}
607回呼び終わるまで、約12分かかりました。画面に出た結果は、東京都1,518人・神奈川県512人・千葉県141人・埼玉県133人・北海道133人。保存したJSONには、58通りの出身地の値に3,399人が分かれて入っています。
47都道府県より多いのは、出身地の値がそろっていないからです。「東京都」と別に「東京」があったり、海外の地名や、出身地とは関係のない言葉が入っていたりしました。ページにするなら、分けたあとに表記を整える工程が要ります。県ごとの人数にも大きな差があるので、人数の少ない県は、近くの県とまとめて1ページにするなどの工夫も必要です。
3か月の運用結果
オーナーは、FANZAのAPIで3週間に約2万ページを自動で作りました。3か月たってインデックスに登録されたのは6,414ページで、残りの約1.65万ページは、クロールはされても登録されませんでした。
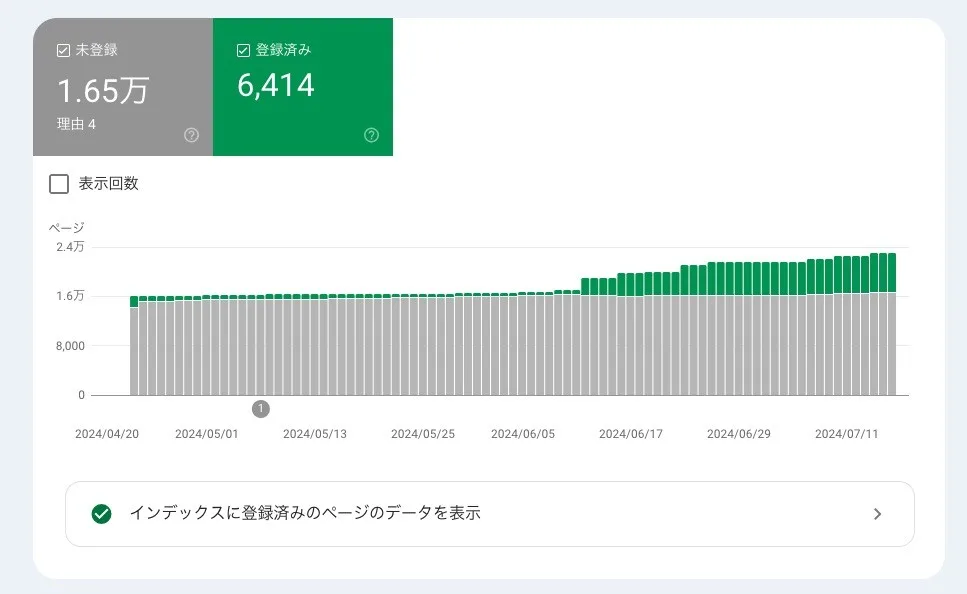
2024年7月当時のオーナーのSearch Consoleの画面(2024年4月20日〜7月中旬)。緑が登録済み、灰色が未登録。
訪問者は1日に2〜3人ほど。検索で来たのは、主に知名度の高くない女優の名前や、特定の作品のタイトルでした。そうしたキーワードでは少し訪問があったものの、上位には表示されないので、全体の訪問はとても少ないまま。
コンセプトを途中で変えた
最初のコンセプトは、かわいい女優を紹介するサイトでした。検索からの訪問も、SNSからの集客も伸びなかったため、途中から、紹介している作品と組み合わせた官能小説をAIに書かせて載せ始めます。
小説を足すと、滞在時間は伸びました。ただ、もう一度来てくれる人はあまり増えず、全体の訪問を大きく増やすところまでは届いていません。オーナー自身、最初のコンセプトがぶれて、誰に向けたサイトなのかが分からなくなった、と振り返っています。
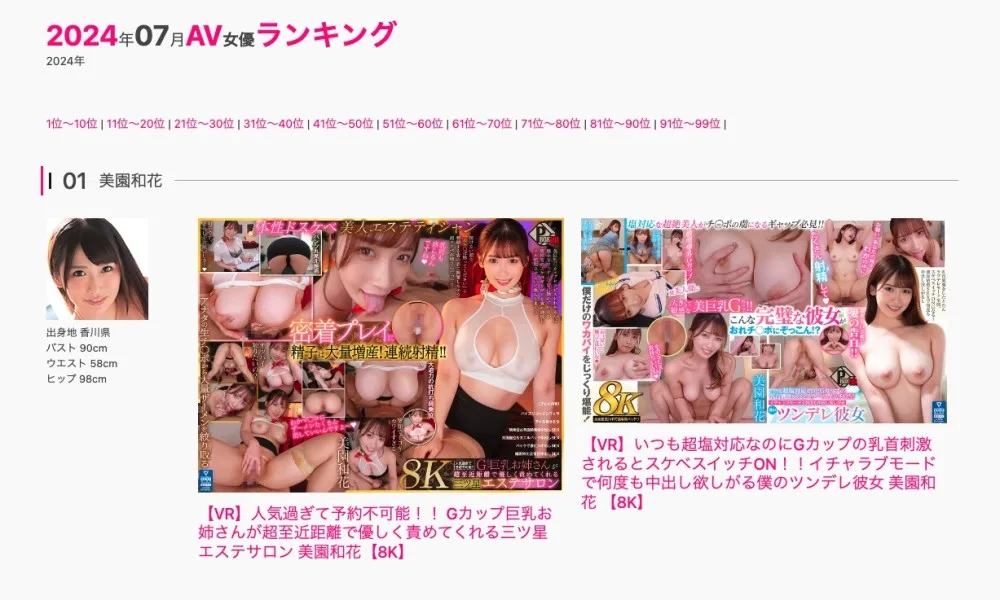
2024年当時の女優の月間ランキングのページ。1位〜99位を10位ずつに分けて並べていた。
Xへの投稿
もともと検索にはあまり期待しておらず、オーナーが望みをかけていたのは、Xからの集客でした。小説を足した段階から、Xに1日1回、約1か月投稿を続けています。それでも、反応のいいハッシュタグや投稿の言葉は見つからず、大きな集客にはつながりませんでした。
インデックスされなかった理由を、今のGoogleの決まりで見ると
インデックスされなかった理由を、オーナーは「APIから取ったデータを、ほぼそのまま表示していたから」と見ていました。同じデータは、APIを使うほかのサイトにも並んでいるので、Googleに重要だと見なされなかった、という考えです。
今のGoogleの決まりに当てはめても、この見立ては筋が通っています。Googleのスパムに関するポリシーには、オーナーのサイトの作りに近い説明が2つありました。
- 大量生成されたコンテンツの不正使用:ユーザーの役に立つためではなく、検索の順位を操作するために、独自性の無いページを大量に作ること。作り方は問わない、と書かれている
- 内容の薄いアフィリエイト サイト:販売元の商品説明をそのまま使い、独自の内容や付け加えた価値が無いまま、アフィリエイトのリンクを載せること。同じテンプレートで同じような中身を並べたサイトが多い、とも書かれている
オーナーのサイトがこの2つに当たると判定されたかどうかは、当時の記事からは分かりません。書かれているのは、残りのページがクロールはされたのに登録されなかった、という結果だけ。当時の画面の未登録の欄には「理由 4」とあり、4つの理由ごとの内訳は残っていません。クロールされたのに登録されないページは、Search Consoleでは「クロール済み - インデックス未登録」と表示され、Googleのヘルプには、今後登録される可能性も、されない可能性もある、と書かれています。
時間をかければ登録は増えたかもしれない、とはオーナーも考えていたそうです。それでも、上位に表示されなければ意味がないと判断して、自動生成したページは全部消すことにしました。
オーナーが決めた、その後の方針
オーナーは、APIで自動生成したページをすべて消し、Search Consoleでインデックスの状況を見直すことにしました。そのうえで、自分の感想や独自の要素を足したレビューに力を入れる方針です。
当時の記事には、次の2つが書かれています。
- APIで作ったページをやめ、AIも使いながら、独自のレビューを中心に運用する
- AIに書かせた小説は、別のサイトで運用する
この方針を受けて、APIの使い方を考え直すなら、Googleの決まりにある「優れたアフィリエイト サイト」の例が手がかりになります。ポリシーでは、価格・独自の商品レビュー・テストと評価・商品やカテゴリのナビゲーション・商品の比較のような情報を足しているサイトを、価値を加えている例に挙げています。

APIのデータは、ページの土台として使い、その上に自分にしか書けない中身を足す。この組み合わせなら、オーナーが3か月かけて分かったことを、最初からサイトの設計に生かせます。
よくある質問
FANZAのAPIは無料で使える?
無料です。DMMの会員登録・DMMアフィリエイトの登録・APIの利用登録をすると、API IDが発行されます。API IDは、1人の会員につき1つです。
FANZAのAPIで、作品の画像やサンプル動画も取れる?
取れます。商品情報APIの応答に、パッケージ画像・サンプル画像・サンプル動画のURLが入っています。ただ、ビデオのフロアの新着100作品で数えると、サンプル画像があるのは96作品、サンプル動画は72作品でした。値があるかを確かめてから表示します。
APIで自動生成したページは、インデックスされない?
自動生成だから登録されない、という決まりはありません。オーナーのサイトでも、約2万ページのうち6,414ページは登録されています。ただ、ほかのサイトと同じデータを並べただけのページは、今のGoogleのスパムに関するポリシーで、価値を加えていない例として挙げられている作りに近くなります。
1日に何回までAPIを呼べる?
公式のリファレンスやご利用ガイドに、1日の回数の上限は見当たりませんでした。利用規約では、アクセスの回数などに制約をかけることがある、と書かれています。全件を取るときは、1回ごとに間を空けて呼ぶのが安全です。
この記事で作ったAPIは、ツールで試せます
キーワードや条件を変えて、APIが返す実際のデータを確かめられます。